Pupupul: что проверяли
Когда говорят о продвижении в ChatGPT, Claude или Perplexity, часто начинают с особых файлов и списков ключевых слов. Мы решили начать с более практичного вопроса: что поисковая система действительно получает, открывая сайт, и может ли она однозначно понять продукт?
Для разбора взяли Pupupul — сервис из Узбекистана для учёта личных денег и финансов бизнеса. На сайте представлены работа с несколькими валютами, финансовые отчёты, калькуляторы и открытое демо. Это удобный пример: здесь есть и продукт, который можно рекомендовать, и материалы, которые можно использовать как источник ответа.
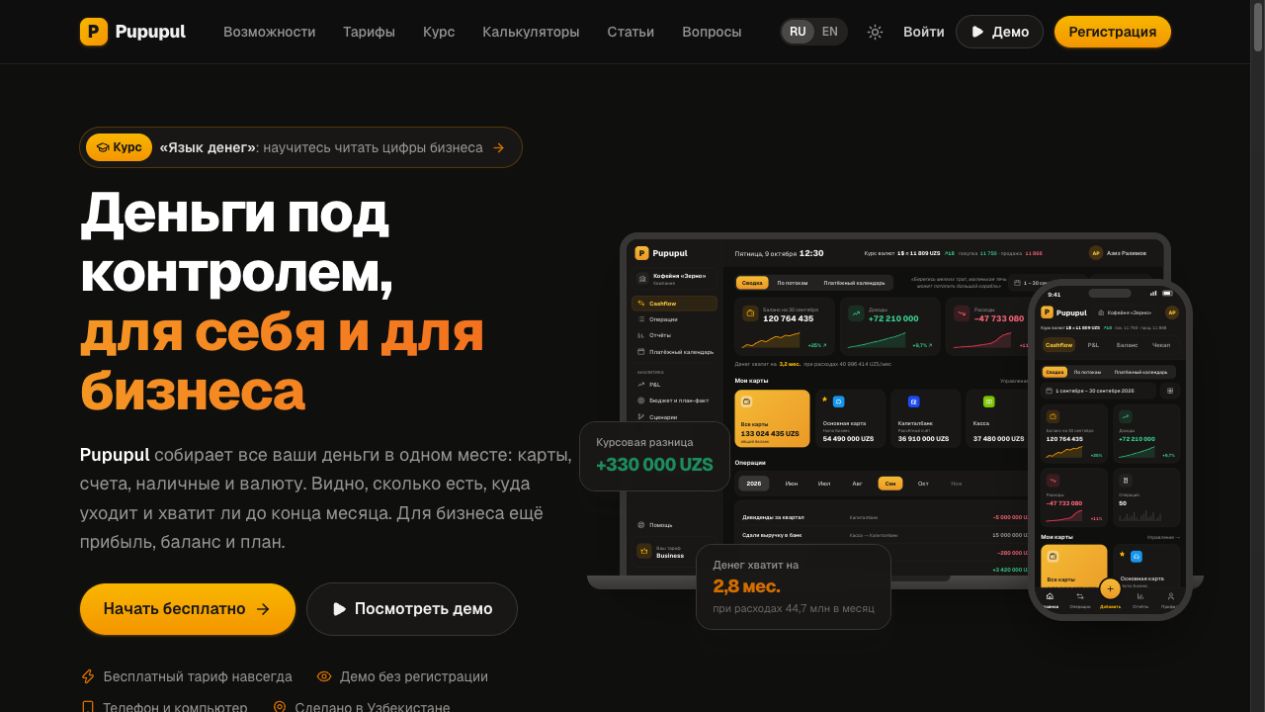
Сначала проверили, доступен ли сайт
Открыли robots.txt, карту сайта и все 19 перечисленных в ней адресов. Проверили ответы сервера, основной адрес каждой страницы — canonical, запреты индексации и наличие текста в исходном HTML.
Результаты проверки: 19 из 19 страниц sitemap вернули HTTP 200; 6 статей с lastmod; 8 страниц калькуляторов.
Во всей этой выборке canonical указывает на собственную страницу, а запретов noindex в HTML и заголовках ответа не обнаружено. Главная и проверенные статьи содержат читаемый текст уже в ответе сервера: исполнять JavaScript, чтобы получить основной материал, не требуется.
Robots.txt разрешает обход публичных страниц. Дополнительно главная вернула HTTP 200 в трёх запросах с User-Agent OAI-SearchBot, Claude-SearchBot и PerplexityBot. Это проверка реакции сервера на такие заголовки, а не доказательство посещения сайта настоящими роботами этих компаний.
Вывод по технической базе: в проверенной выборке общего запрета на обход или индексацию не нашли. Перестраивать сайт только ради того, чтобы «ИИ увидел HTML», по этим результатам не требуется.
Для AI Overviews и AI Mode Google сохраняет обычные требования поиска: страница должна быть проиндексирована и допускать показ сниппета. Специальная разметка «для попадания в ИИ» не нужна. Источник: Google Search Central .
Первая правка: единое описание тарифов
Самая заметная проблема нашлась в содержании главной. Бесплатный бизнес-тариф Mini включает P&L и Баланс. При этом в FAQ эти возможности перечислены среди причин перейти на платный тариф, а в блоке «Что внутри» P&L и Баланс отмечены меткой Business. Все три формулировки доступны в исходном HTML одной страницы.
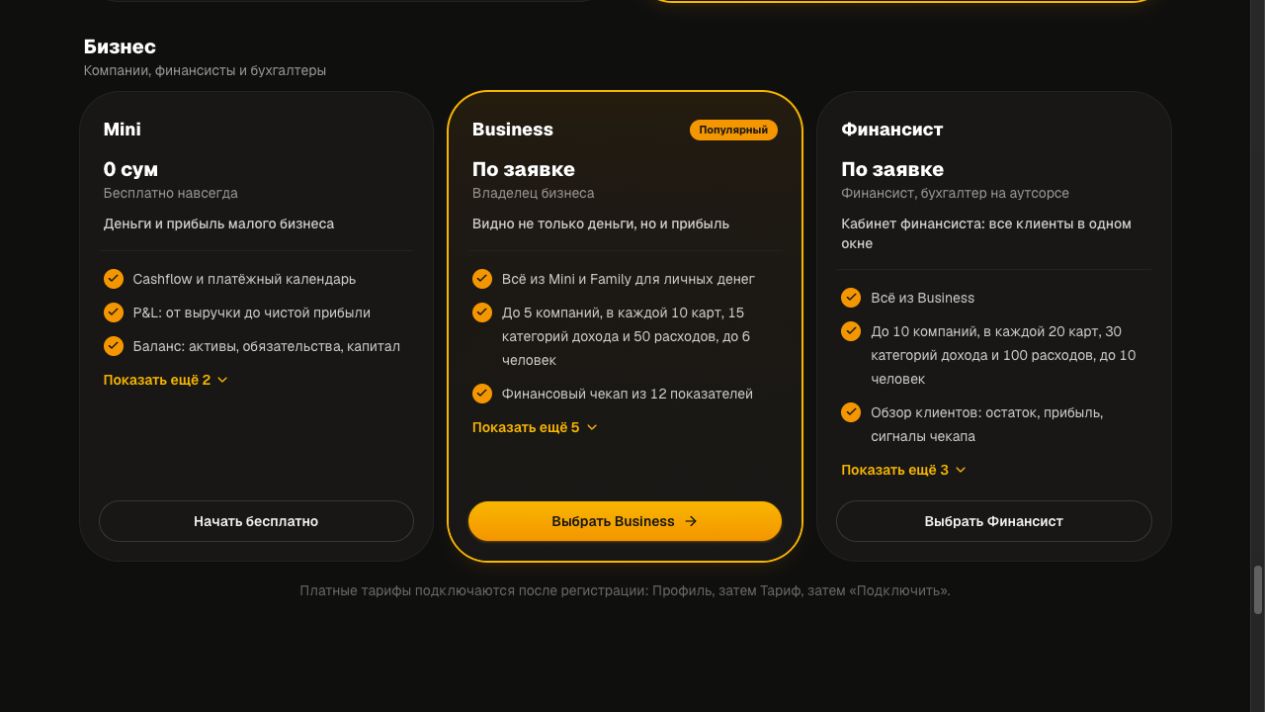
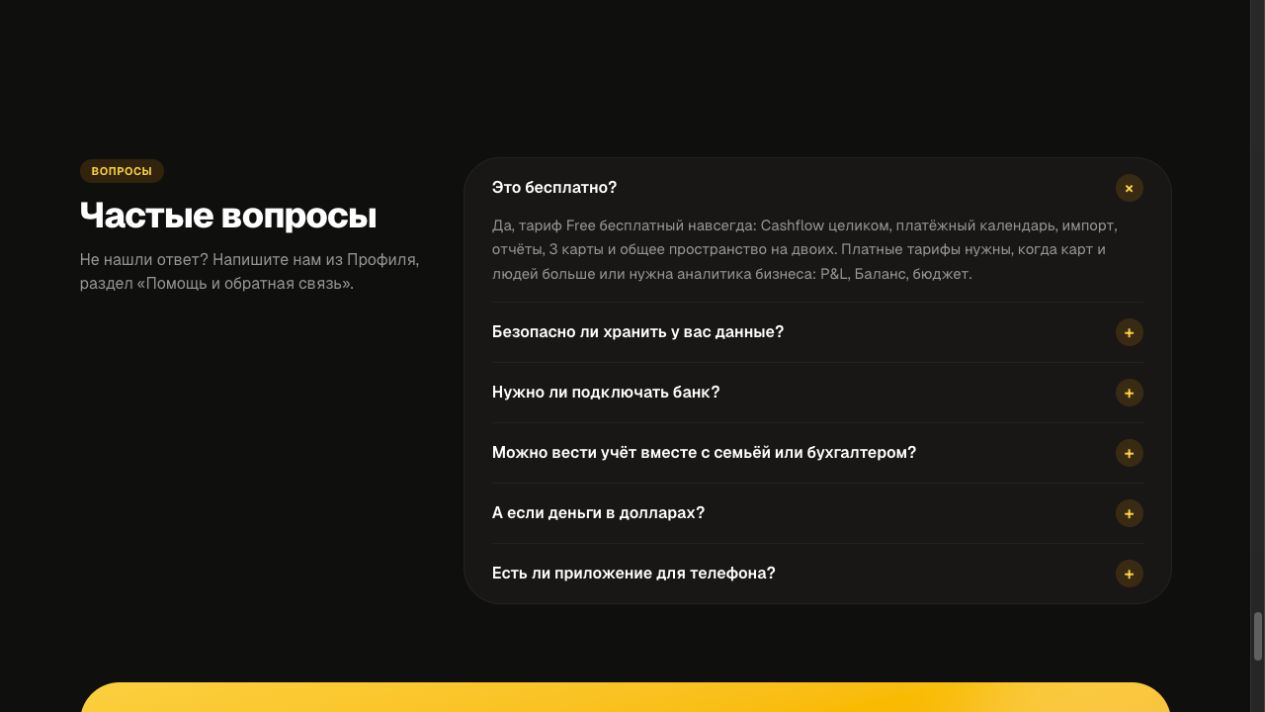
Для человека это повод уточнить условия. Для системы, которая собирает ответ из фрагментов страницы, — неоднозначность: один фрагмент позволяет назвать функцию бесплатной, другой — платной. Это наш вывод о качестве информации; влияния конкретно этого расхождения на ответы моделей мы не измеряли.
Что сделать: подтвердить актуальную матрицу тарифов и синхронизировать с ней карточки, FAQ, блок возможностей и будущую разметку. Если доступ зависит от лимитов или состава отчёта, описать различие прямо. Здесь важнее точные условия, чем дополнительное повторение названия бренда.
Вторая правка: отдельные адреса для языков
На сайте есть переключатель русского и английского. При проверке главной английский текст возвращался на том же URL в зависимости от заголовка Accept-Language или языковой cookie. Отдельных ссылок на языковые версии и hreflang на проверенных страницах не обнаружено. При этом английский HTML сохранял lang="ru".
Google рекомендует отдельные URL для языковых версий вместо зависимости от cookie и настроек браузера: иначе поисковик может не обнаружить все варианты. Источник: документация Google о многоязычных сайтах .
Что сделать: выделить стабильные адреса, например /ru/ и /en/ , связать переводы обычными ссылками и hreflang, задать соответствующие canonical и язык документа. Это предлагаемая структура, а не существующие адреса Pupupul. Для англоязычной аудитории такая доработка выглядит приоритетной.
Неверный lang стоит исправить для корректности разметки и доступности. При этом Google определяет язык по видимому тексту, поэтому объявлять один этот атрибут причиной отсутствия индексации было бы неверно.
Третье улучшение: яснее описать продукт и авторство
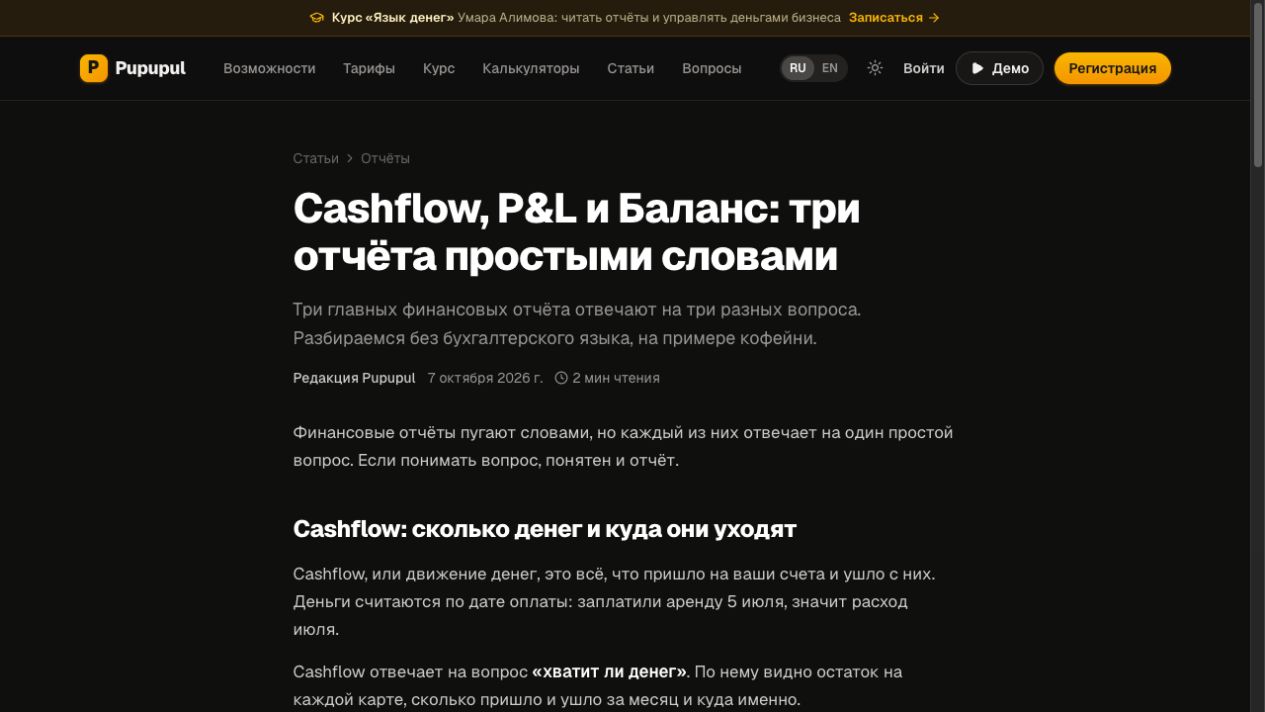
У Pupupul уже есть полезный контент. Например, материал о Cashflow, P&L и Балансе разделяет тему на понятные вопросы и связывает объяснение с демо продукта. У шести проверенных статей видны дата и подпись редакции.
На 19 проверенных страницах не нашли JSON-LD или microdata. Добавить структурированное описание продукта, организации и статей можно как следующий шаг: SoftwareApplication, Organization, Article и BreadcrumbList там, где они соответствуют содержанию. Даты и авторы в разметке должны совпадать с видимыми данными.
Для материалов о финансах я бы также добавил понятную страницу об авторах и редакционной проверке, ссылки на первоисточники там, где приводятся проверяемые внешние факты, и описание допущений калькуляторов. Указывать специалиста стоит только тогда, когда он действительно участвовал в подготовке или проверке.
Отсутствие schema само по себе не закрывает сайт для поиска и не доказывает отсутствие цитирования. Приоритет здесь — согласованные факты и полезный материал, а разметка описывает их.
Какие вопросы проверять дальше
Чтобы оценивать рекомендации, нужны вопросы потенциального пользователя, а не только запрос с названием Pupupul. Для следующего этапа мы бы взяли такие сценарии:
• Какой сервис подходит для учёта денег малого бизнеса в Узбекистане? • Где вести личные расходы в сумах и долларах? • Есть ли бесплатный сервис с P&L и Балансом для малого бизнеса? • Какой инструмент выбрать для семейного бюджета в нескольких валютах?
Это предложенные сценарии проверки, а не выгрузка реальных запросов пользователей и не оценка их частотности. По каждому стоит сохранять дату, выбранный ИИ, сам ответ и ссылки: упомянут ли Pupupul, что сказано о тарифах и ведёт ли цитирование на нужную страницу.
В каком порядке я бы продолжил работу
1 — Условия тарифов во всех блоках — В HTML нет противоречий о доступности P&L и Баланса
2 — Адреса и ссылки языковых версий — Каждый перевод открывается по своему URL без зависимости от cookie
3 — Описание продукта, авторов и разметка — Факты, даты и авторство совпадают с видимой страницей
4 — Проверка обнаружения и результата — Данные поисковика, ответы ИИ со ссылками и наблюдаемые переходы
После публикации исправлений — проверить важные адреса в Google Search Console и Bing Webmaster, затем повторить выбранные вопросы в ИИ и сопоставить ответы. Для переходов потребуется аналитика самого сайта: часть источников определяется по рефереру и меткам, а часть визитов остаётся без распознанного источника.
Такой разбор показывает, зачем мы делаем AURA GEO : связывать проверку сайта, конкретные задачи, работу агента и подтверждённый результат. Сначала привести информацию в порядок, затем проверить, что изменилось в поиске, ответах и переходах.
О проверке
Разбор выполнен 18 октября 2026 года по публичным страницам, HTTP-ответам, robots.txt, sitemap и исходному HTML. Рекомендации в этой статье ещё не внесены на сайт Pupupul. Его посещаемость, фактические позиции в индексах и цитирования в ответах моделей в рамках этой проверки не измерялись.
Протокол аудита и первоисточники приведены в списке ниже. Доступность страницы для запроса и её выбор источником ответа — разные этапы.
Источники
- https://www.pupupul.uz/
- https://www.pupupul.uz/#pricing
- https://www.pupupul.uz/#faq
- https://www.pupupul.uz/robots.txt
- https://www.pupupul.uz/sitemap.xml
- https://www.pupupul.uz/articles/cashflow-pnl-balans-prostymi-slovami
- https://developers.google.com/search/docs/appearance/ai-features
- https://developers.google.com/search/docs/specialty/international/managing-multi-regional-sites
- https://developers.openai.com/api/docs/bots
- https://aurageo.io/assets/articles/pupupul-geo-review/audit.json